
Побудова вашого “ШІ-Спокою”: Систематизований Підхід до Інформаційного Перевантаження
Від Ліли Гарт, Старшого Редактора та Експерта з Бізнес-Аналізу, Автоматизації та Штучного Інтелекту
Присядьте зручніше, налийте собі улюблений напій. Сьогодні ми зануримося в складний, але захопливий світ штучного інтелекту (ШІ). Як людина, яка працює на перетині бізнес-аналізу, автоматизації та ШІ вже понад два десятиліття, я спостерігала, як ця галузь трансформується зі швидкості світла. З кожним днем з’являються нові моделі, релизы, вірусні обговорення та нескінченні списки репозиторіїв на GitHub, які, здається, ніколи не закінчуються. Це відчуття перевантаження знайоме багатьом.
Нещодавно я мала розмову з колегою-розробником, Максом. Він описав це відчуття як “бути серфінгістом, який намагається втриматися на гігантській хвилі новин про ШІ”. Його метафора вразила мене своєю точністю, адже вона ідеально відображає виклик, з яким стикаються професіонали в нашій сфері: як відфільтрувати справді цінну інформацію з цього шаленого потоку? Як відрізнити надійний сигнал від інформаційного шуму?
Протягом останнього року я присвятила значну частину своєї роботи пошуку відповідей на ці запитання. Я розробляла, тестувала, і, звісно, стикалася з викликами, але зрештою створила те, що я називаю своєю “системою спокою” – мій персональний ШІ-контент-двигун, інтегрований у мій “другий мозок”. Це не просто інструмент, а мовчазний, але ефективний помічник, який працює цілодобово, відстежуючи сотні джерел, фільтруючи інформацію відповідно до моїх професійних інтересів та щоранку надаючи лаконічний, але вичерпний “щоденний дайджест”. Цей процес виключає зайві деталі, залишаючи лише те, що дійсно сприяє моїй роботі, проєктам та професійному розвитку.
У цій статті я не лише поділюся деталями функціонування моєї системи, але й покажу, як ви можете побудувати власну, використовуючи один потужний навик, який я розробила. Цей підхід зекономив мені десятки годин щотижня, дозволяючи зосередитися на стратегічних завданнях, а не на рутинному відстеженні інформації.
ШІ-Потік: Стратегія Виживання в Інформаційному Океані
Уявіть себе в затишній кав’ярні, де приємний гул створює ідеальну атмосферу для роботи. А тепер уявіть, що це приємне оточення – це весь інтернет, а новини про ШІ – це натовп відвідувачів, кожен з яких щось кричить, показує чи пропонує. Ваше завдання – виділити серед них тих, хто несе цінну інформацію саме для вас. Це, безумовно, складний виклик.
Я теж відчувала цю складність, поки не усвідомила: немає потреби бути “серфінгістом”, який бореться з кожною хвилею. Натомість, мені був потрібен власний “рятувальний круг” – інтелектуальна система, яка візьме на себе весь обсяг рутинної роботи.
Саме тому я розробила “Build Signal Engine”. Я називаю його так, бо його основна функція – виділяти “сигнали” – тобто, найважливіші новини та інсайти – з усього цього інформаційного хаосу.
Чому я називаю це “навичкою” (skill), а не просто готовим кодом для копіювання? Тому що я прагну не просто надати вам інструмент, а й забезпечити глибоке розуміння його роботи. Коли ви будуєте систему самостійно, ви засвоюєте її архітектуру, можете адаптувати її до своїх специфічних потреб та постійно вдосконалювати. Ця “навичка” діє як ваш особистий “шеф-кухар”, який проводить вас через усі етапи створення вашого ідеального інформаційного “меню”.
Архітектура Системи: Збір Цінних Даних
Перш ніж ми перейдемо до побудови, важливо зрозуміти, як працює система. Як кажуть, “довіряй, але перевіряй”, особливо коли мова йде про технології, які мають оптимізувати вашу роботу.
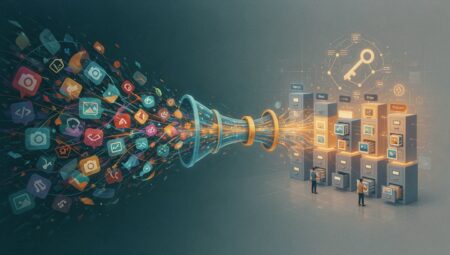
Уявіть нашу систему як високоорганізований центральний сховище даних, де зберігається найактуальніша інформація про ШІ. Для ефективного функціонування такого сховища нам необхідний “дата-лейер” (data layer) – шар даних. Це, по суті, інтеграція з різними платформами, звідки ми будемо отримувати інформацію.
Перелік цих платформ може бути різноманітним, залежно від ваших професійних інтересів. Серед найпоширеніших джерел, які я активно використовувала у своїх проєктах, є:
- Reddit: Безцінне джерело дискусій, де можна знайти як глибокі аналітичні пости, так і технічні новини.
- YouTube: Пропонує багатий контент у вигляді оглядів, навчальних матеріалів та демонстрацій нових інструментів.
- RSS-стрічки: Класичний, але все ще ефективний спосіб отримувати новини з вашого улюбленого контенту.
- Hacker News: Чудове джерело для тих, хто цікавиться технічними деталями та дискусіями серед розробників.
- GitHub: Епіцентр розробки, де народжуються нові проєкти та виходять оновлення.
- Changelogs: Важливі для відстеження змін у функціоналі платформ, таких як Claude чи Code Llama.
Цей список потенційних джерел є величезним, охоплюючи сотні платформ щодня. Однак, моя система розроблена для ефективної обробки цих даних, уникаючи надмірності.
Практичний Інсайт: Раніше, я мала окремі запити до кожної платформи. Це було схоже на пошук інгредієнтів для складної страви, обходячи десятки магазинів. Але завдяки Apify, я отримала універсальний інструмент, який діє як єдиний центр доступу до величезної кількості джерел, навіть тих, які мають обмежений API. Це значно спрощує процес збору даних.
Таким чином, перший етап – це ідентифікація джерел даних, а другий – визначення оптимальних методів їх вилучення. Це може бути прямий API-запит, використання спеціалізованих інструментів командного рядка (CLI), або ж гнучкість Apify. Навичка “Build Signal Engine” допоможе вам обрати найбільш підходящий метод.
Дедуплікація та Фільтрація: Відсікання Інформаційного “Сміття”
Після збору даних, настає етап їх очищення та організації. Це аналогічно тому, як ви сортуєте продукти після покупки: миєте, очищаєте, викидаєте зіпсовані.
Першим кроком, який робить система при запуску, є дедуплікація. Це критично важливий процес, який запобігає повторній обробці тієї ж інформації. У контексті роботи з великими мовними моделями (LLM), це означає уникнення марної витрати “токенів” – нашої цифрової “валюти”.
Після дедуплікації застосовуються кодові фільтри. Ці фільтри – це ваші персональні правила, які визначають, яка інформація є релевантною:
- Відсікання застарілої інформації: Якщо публікація вийшла значний час тому, і не має оновлень, її актуальність, ймовірно, низька.
- Аналіз популярності: Для контенту на платформах, таких як Hacker News чи YouTube, невелика кількість переглядів може свідчити про відносно низьку важливість. Звичайно, це не абсолютне правило, але це слугує корисним орієнтиром.
Важливо зазначити, що ці фільтри працюють без залучення ресурсномістких LLM, що забезпечує високу швидкість та економічну ефективність системи. Це як підготувати простір перед прийомом гостей – позбутися непотрібного, щоб звільнити місце для найважливішого.
Jev та LLM: Інтелектуальні Помічники в Прийнятті Рішень
Ми підійшли до найцікавішого етапу – інтеграції “інтелектуальних помічників”, які допомагають відфільтрувати цінну інформацію від другорядної.
Раніше я експериментувала з використанням виключно LLM для всіх завдань. Це виявилося досить дороговартісним, і, як показала практика, іноді LLM пропускали дійсно важливі новини, або ж відхиляли цінний контент.
Тому я знайшла оптимальне рішення – Jev. Це “молодший помічник”, який ефективно вирішує очевидні завдання. Він аналізує новину та робить висновок: “Це точно не цікаво” або “Це саме те, що нам потрібно”. Якщо Jev впевнений у своєму рішенні, пост одразу відхиляється або зберігається, що значно економить ресурси LLM.
Але що робити, коли Jev не впевнений, або коли потрібен глибший аналіз? Ось тут на сцену виходить “старший помічник” – потужна LLM, наприклад, Claude Haiku. Вона проводить більш глибокий аналіз, враховує контекст та допомагає підготувати інформацію для вашого щоденного дайджесту.
Ключові Цифри для Вашого Розуміння: Зазвичай, моя система обробляє близько 864 пости на день, і це коштує менше 50 центів. Порівняйте це з годинами, які ви витрачаєте на ручний пошук інформації, і ви побачите значну економічну вигоду.
Критичний Момент: Перед тим, як передати текст для обробки Jev або LLM, завжди намагайтеся його “очистити”. Це включає видалення зайвих заголовків, підписів, порожніх рядків. Apify виконує це автоматично, але якщо ви будуєте свою систему, пам’ятайте про цей етап.
Демонстрація: Практичне Застосування
Для кращого розуміння, я підготувала демонстрацію, яка показує, як Jev фільтрує пости з Reddit, а потім деякі з них передаються до LLM.
Jev аналізує кожен пост за трьома ключовими критеріями:
- Релевантність: Чи стосується новина ШІ та вашої професійної діяльності?
- Новизна та Цінність: Чи це дійсно нова та цінна інформація, а не черговий “іграшковий” демо-проєкт?
- Особистісна Цікавість (Персоналізація): Чи відповідає новина вашим індивідуальним інтересам?
Якщо пост отримує низький бал за цими критеріями, Jev одразу його відхиляє. Наприклад, якщо це черговий “toy demo”, ми його пропускаємо, щоб не витрачати час на те, що вже пройдене.
Але якщо пост дійсно цінний, як-от анонс нової моделі Sonnet 5.5 чи випуск Claude 1.0, Jev одразу позначає його як “до зберігання”. У таких випадках, використання LLM може бути навіть непотрібним.
У випадках, коли ситуація більш неоднозначна, або коли потрібно врахувати ваш особистий контекст, включається LLM для більш глибокого аналізу.
Конфігурація: Універсальний Контроль
Керування цією системою неймовірно просте. Весь процес конфігурації здійснюється через один JSON-файл, який виступає як ваш персональний “пульт управління” доступом до інформації:
- Всі RSS-стрічки, які ви хочете відстежувати.
- Список YouTube-каналів для моніторингу.
- GitHub-репозиторії, що вас цікавлять.
- Категорії для наукових досліджень.
- Запити для Apify (Reddit, веб-пошук, YouTube).
Це робить управління системою максимально зручним. За допомогою цього файлу ви відчуваєте повний контроль над інформаційним потоком.
Побудова Вашої Системи: Покроковий Підхід
Тепер перейдемо до практичної частини: як побудувати вашу власну систему.
Я розробила спеціальну “навичку” (skill) – “Build Signal Engine”. Її мета – провести вас через увесь процес крок за кроком.
- Встановлення: Найпростіший спосіб – знайти її в моєму GitHub-репозиторії (посилання буде в описі). Якщо ви використовуєте Cloud Code, існує спеціальний плагін, який спростить цей процес. Якщо у вас інший агент, просто вкажіть йому на репозиторій.
- Запуск: У вашому новому репозиторії (рекомендовано створити окремий для цього) введіть команду
/build signal engine. - “Інтерв’ю” з Системою: Це найважливіша частина! Система проведе з вами “співбесіду”, ставлячи такі запитання:
- Де ви хочете розмістити цю систему?
- Які теми вас цікавлять?
- Які саме проблеми ви намагаєтеся вирішити? (Наприклад, чи не пропустили ви важливе оновлення, чи не дізналися про новий інструмент надто пізно?)
- Які джерела ви хочете відстежувати?
- Які методи отримання даних ви віддаєте перевагу? (API, Apify, тощо)
Відповідайте чесно та детально. Це займе приблизно 10-15 хвилин, але це інвестиція, яка окупиться сторицею. Чим краще ви опишете свої потреби, тим точніше система буде працювати.
Шість Етапів до Вашого “Другого Мозку”
Після “інтерв’ю”, система розпочне роботу. Вона пройде шість етапів, де на кожному буде проводитися тестування:
- Налаштування одного джерела: Почнемо з мінімального набору – одного обраного вами джерела.
- Побудова шару даних: Інтеграція всіх ваших джерел згідно з вашими уподобаннями (API, Apify тощо).
- Застосування кодових фільтрів: Налаштування механізмів відсікання зайвої інформації.
- Інтеграція Jev та LLM: Підключення інтелектуальних помічників для прийняття рішень.
- Визначення формату дайджесту: Формування структури вашої щоденної “порції” новин.
- Налаштування розкладу: Встановлення частоти оновлень та сповіщень.
Це процес, аналогічний будівництву будинку: спочатку фундамент, потім стіни, дах, і тільки потім – внутрішнє оздоблення. Кожен етап ретельно тестується, щоб гарантувати стабільність системи.
Профіль: Ваш Персональний “Гід”
Після завершення побудови, система створить для вас “профіль”. Це ваша персональна інструкція до вашої системи: які джерела ви відстежуєте, які фільтри використовуєте, які запитання ставите Jev та LLM.
Найкраще в цьому – гнучкість. Якщо щось не зовсім так, як ви хотіли, ви можете просто написати це природною мовою, наприклад: “Зроби так, щоб я отримував більше новин про мобільну розробку” або “Зменш кількість постів про конкретні фреймворки”. Система внесе відповідні зміни. Ваш “другий мозок” завжди можна вдосконалювати!
Висновок: Ваш Спокій у Світі ШІ
Ось так функціонує мій ШІ-контент-двигун. Це не просто інструмент, це мій спосіб залишатися в курсі подій, не витрачаючи при цьому всі сили та час. Це моя “зона спокою” в бурхливому океані новин про ШІ.
Навіть якщо ви не будете будувати всю систему з нуля, я сподіваюся, ви отримали кілька цінних ідей, які зможете інтегрувати у свій робочий процес. Можливо, це ідеї щодо дедуплікації, використання Jev як першої лінії фільтрації, або просто усвідомлення можливості автоматизації цього процесу.
Ключовий висновок: Світ технологій швидко змінюється, але це не означає, що ви маєте бути постійно перевантажені. Створюючи правильні інструменти, ви можете перетворити інформаційний хаос на керований потік цінної інформації.
Що Далі?
- Спробуйте Самі! Завітайте за посиланням на мій GitHub-репозиторій та почніть будувати свою систему.
- Експериментуйте! Не бійтеся змінювати налаштування, додавати нові джерела, оптимізувати фільтри.
- Поділіться Своїм Досвідом! Залиште коментар, опишіть свій прогрес, цікаві джерела, які ви знайшли, або проблеми, які вдалося вирішити.
Пам’ятайте, ви не самотні у прагненні зрозуміти та ефективно використовувати потужність ШІ. Ми разом будуємо наше майбутнє, і я рада бути вашим провідником у цій захопливій подорожі.
До наступної зустрічі, і нехай ваш інформаційний потік завжди буде цікавим та корисним!