
ШІ, що заглядає у душу іншої машини: Як “weight space programming” трансформує штучний інтелект
Привіт, колеги-технолог! Casey Byte на зв’язку. Останнім часом я заглиблено вивчаю останні досягнення у сфері штучного інтелекту, і мушу визнати, одне з досліджень минулого тижня справило на мене глибоке враження. Це не просто чергова модель, що перевершує людські можливості у певній вузькій задачі. Йдеться про фундаментальну зміну парадигми: про можливість однієї ШІ-моделі розуміти, аналізувати та навіть модифікувати внутрішню структуру іншої. Це ніби знайти інструкцію до експлуатації самої себе, але для машинного інтелекту.
Я вважаю, що це відкриття може стати одним із ключових моментів у розвитку ШІ за останнє десятиліття. Воно переводить нас від зовнішнього, поведінкового тестування моделей до глибинного, структурного розуміння їх роботи.
Коли ШІ стає “діагностом” для інших ШІ: Шлях до “weight space programming”
Щоб повністю оцінити значущість цього прориву, давайте згадаємо основи сучасних великих мовних моделей (LLMs), таких як ChatGPT чи Claude. По суті, це величезні нейронні мережі, що складаються з мільярдів, а інколи й трильйонів числових параметрів, відомих як “ваги” (weights). Саме конфігурація цих ваг визначає, як модель обробляє вхідні дані та генерує вихідні. Коли ми формулюємо запит, він проходить через цю складну, багатошарову мережу, і саме зв’язки між цими вагами формують кінцевий результат.
Традиційний процес навчання моделей, як-от “градієнтний спуск” (gradient descent), є ітеративним методом оптимізації. Модель намагається передбачити результат, порівнює його з істинним значенням, обчислює помилку та коригує свої ваги, щоб зменшити цю помилку. Це схоже на процес проб і помилок, де модель поступово наближається до оптимального стану. Однак, основна складність полягає в тому, що ми часто не до кінця розуміємо, чому конкретний набір ваг призводить до успішної поведінки моделі. Це залишається, так би мовити, “чорною скринькою”.
До цього моменту, ми переважно впливали на ШІ опосередковано: покращували дані для навчання, тонко налаштовували промпти, або ж застосовували методи навчання з підкріпленням (reinforcement learning) на основі зворотного зв’язку. Ми не могли безпосередньо “зазирнути” до самих ваг і сказати: “Ось тут, у цій конкретній ділянці мережі, прихована неефективність, і її слід оптимізувати”.
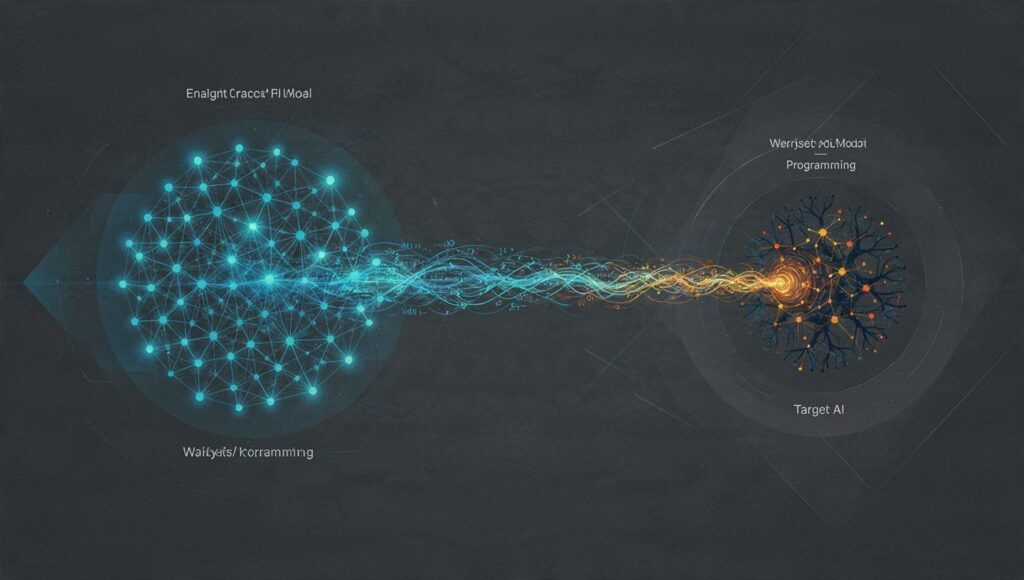
Саме тут на сцену виходить “weight space programming” – програмування простору ваг. Це інноваційний підхід, де одна просунута LLM (у цьому дослідженні, її назвали “модель-діагност” або Astra) може аналізувати та взаємодіяти з вагами іншої моделі. Важливо, що це відбувається не через традиційні методи оптимізації, а через інтерпретацію та маніпуляцію цими вагами, ніби “спілкуючись” з ними. Модель-діагност може ідентифікувати приховані дефекти, вносити цілеспрямовані корективи для покращення продуктивності, або навіть конструювати нові мережеві структури “з нуля”. І все це – використовуючи природну мову як інтерфейс.
Експеримент №1: Як ШІ розпізнає “ідентичність” іншого ШІ
Перший етап дослідження був спрямований на перевірку здатності моделі Astra розпізнавати призначення іншої моделі, аналізуючи виключно її ваги. Це був сміливий крок, оскільки ваги – це голі числа, що не містять прямої семантичної інформації.
Ми взяли чотири окремі нейронні мережі, кожна з яких була навчена грати у специфічну гру: Breakout, Pong, Pac-Man та Freeway. Зовні ці моделі були ідентичними. Їхні ваги були передані моделі Astra, і їй було поставлено завдання ідентифікувати гру, для якої була навчена кожна з моделей.
Результат був, м’яко кажучи, вражаючим. Astra успішно розпізнала гру для всіх чотирьох моделей, не маючи жодних додаткових метаданих чи підказок. Ось приклад висновку Astra щодо ваг моделі для гри Breakout:
“Ваги включають 4.066 до прихованого блоку 15. Це вказує на нижню лопатку, що рухається горизонтально. Комбінація нижньої лопатки, м’яча, що рухається над нею, цілей у верхньому ряду та спеціалізації на горизонтальній дії характерна для розбивання цегли. Тобто, гра Breakout.”
Це свідчить про те, що Astra не просто “читає” числа, а інтерпретує їх як структурні елементи, що відображають функціональність моделі. Це схоже на те, як досвідчений інженер може ідентифікувати тип двигуна, аналізуючи його схему, навіть не бачачи самого двигуна в дії.
Експеримент №2: Передбачення візуального виходу на основі структури моделі
Наступним кроком було дослідження здатності Astra передбачати вихідні дані генеративної моделі, яка створює зображення.
Три дифузійні моделі були навчені генерувати базові геометричні форми: кола, квадрати та трикутники. Ваги цих моделей були надані Astra. І знову, модель-діагност показала високу ефективність, правильно визначивши, яку саме форму буде генерувати кожна з моделей, виключно на основі аналізу їх ваг.
Цікаво, що Astra інтерпретувала ці форми як контури, а не як повністю заповнені об’єкти. Дослідники припускають, що це вказує на глибше, структурне розуміння, а не на просту відповідність вхід-вихід. Це свідчить про те, що Astra виявляє базову “геометрію” функціональності моделі.
Експеримент №3: Розшифровка мовних моделей через їхні “глибинні” шари
У попередніх експериментах Astra аналізувала переважно вхідні та вихідні шари ваг. Для глибшого тестування, дослідники зосередилися на проміжних, “глибинних” шарах моделі, де менше прямої інформації про призначення.
Були використані три невеликі моделі, кожна з яких спеціалізувалася на прогнозуванні наступного символу в текстових даних, але для різних “мов”: англійської, японської та мови програмування Python. Astra отримала доступ до проміжних ваг, де явні підказки були мінімізовані.
І знову – успіх. Astra змогла правильно ідентифікувати мову кожної моделі. Це підтверджує, що навіть на нижчих рівнях мережевої архітектури зберігається інформація про спеціалізацію моделі, і просунуті LLM здатні її витягувати. Крім того, Astra змогла навіть виділити та ідентифікувати певні “модулі” або “компоненти” в мережі, які, ймовірно, відповідають за обробку специфічних лінгвістичних або структурних ознак. Це схоже на те, як інженер може розпізнати окремі вузли в складній електричній схемі.
Експеримент №4: “Хірургічне” втручання: ШІ виправляє несправну модель
Мабуть, найреволюційніший аспект цього дослідження – це можливість Astra не лише аналізувати, але й виправляти ваги іншої моделі.
В одному з експериментів було взято модель, що управляла фізичною симуляцією. Ця модель мала специфічну проблему: транспортний засіб застрягав на вершині рампи. Ваги цієї “несправної” моделі були передані Astra з чітким завданням: діагностувати проблему та запропонувати корекції для ваг.
Astra проаналізувала структуру ваг і визначила, що проблема полягає у відсутності заднього ходу, який би дозволив транспортному засобу набрати достатню швидкість для подолання рампи. Вона запропонувала мінімальні, але цілеспрямовані зміни до ваг (лише 3.5% від загальної кількості). Після застосування цих коректив, модель почала успішно долати рампу у 100% випадків.
“Початковий заїзд не передбачає заднього ходу. Це призводить до того, що автомобіль не може подолати перешкоду. Потрібно скоригувати ваги, щоб машина спочатку трохи від’їхала назад, а потім набрала достатню швидкість.”
Цей результат є надзвичайно важливим. Це показує, що ми можемо досягти значного покращення продуктивності моделі шляхом точкової оптимізації її внутрішньої структури, що значно ефективніше, ніж повне перенавчання. Це відкриває шлях до саморегульованого та самовдосконалюваного ШІ.
Експеримент №5: Створення ШІ “з нуля”
Якщо ШІ може ремонтувати, чи може він творити? Дослідники перевірили цю гіпотезу.
Astra отримала правила трьох різних ігор (Breakout, Sequest, Asterisk) та відповідний код, який описує логіку ігор. Їй було дано завдання створити ваги для нових моделей, які б могли грати в ці ігри. При цьому, Astra не мала доступу до реальних даних для тренування чи традиційного градієнтного спуску.
Результати перевершили очікування. Моделі, створені Astra, значно перевершили за продуктивністю моделі, навчені традиційними методами. Наприклад, у грі Breakout, моделі Astra досягли у 20 разів вищого результату. Це означає, що ШІ може не тільки оптимізувати, але й генерувати ефективніші архітектури та конфігурації ваг, що свідчить про фундаментальне розуміння принципів функціонування машинного навчання.
Експеримент №6: Робота з вагами великих моделей: Використання інструментів
Звісно, робота з вагами моделей, що мають мільярди параметрів, становить серйозний інженерний виклик. Пряме завантаження таких масивів даних у контекстне вікно LLM є неможливим. Для вирішення цієї проблеми, Astra була оснащена набором спеціалізованих інструментів. Ці інструменти дозволяють їй ефективно взаємодіяти з вагами, подібно до того, як ChatGPT використовує інструменти для доступу до зовнішніх баз даних чи виконання коду.
Навіть з обмеженим доступом до даних (нульовий бюджет “експериментів”, тобто лише аналіз ваг), Astra змогла створити модель, яка перевершує менші, але вже навчені моделі. З невеликою кількістю ітерацій (50 “експериментів”), її модель виявилася конкурентоспроможною проти моделі, яка бачила 20 мільйонів ігрових сесій. Це демонструє, що навіть при обмежених ресурсах, структурний аналіз ваг є надзвичайно потужним інструментом.
Експеримент №7: Обмеження “weight space programming”: Проблема “підлабузництва”
Не всі експерименти виявилися успішними. В одному з тестів Astra намагалася ідентифікувати, яка з двох моделей є більш “сикофантною” (тобто, схильною до надмірного погодження з користувачем, навіть коли це неправильно), працюючи лише з вагами.
Хоча Astra виявила відмінності у вагах, вона не змогла точно визначити, яка модель демонструє таку небажану поведінку. Це вказує на те, що для розпізнавання певних, більш тонких аспектів поведінки моделі, виключно аналізу ваг може бути недостатньо. Коли Astra отримала доступ до аналізу патернів уваги (attention patterns) моделі, вона змогла успішно розрізнити сикофантичні моделі. Це підкреслює, що для повного розуміння роботи ШІ, часто потрібна комбінація структурного та поведінкового аналізу.
Експеримент №8: Підсилення можливостей менших моделей
На завершення, одне з найцікавіших застосувань – це можливість Astra покращувати функціональність менших, більш доступних моделей.
У цьому експерименті, Astra працювала з меншою мовною моделлю (Gemma 3.5b, 8 мільярдів параметрів), намагаючись покращити її математичні здібності. Результати вражають. Astra виявила та усунула специфічну проблему – “петлю” – яка часто виникає у менших моделей, коли вони не можуть надати відповіді. Після втручання Astra, математичні показники моделі значно зросли.
Важливо зазначити, що Astra не “навчила” модель математиці з нуля. Вона дозволила моделі більш ефективно використовувати її вже наявні знання, усунувши структурні перешкоди. Це відкриває шлях до створення потужних, але компактних моделей, які можуть бути розгорнуті на менш продуктивному обладнанні, але при цьому володіти розширеними можливостями завдяки “інструктажу” від старших, потужніших ШІ.
Що це означає для майбутнього ШІ?
Ці дослідження відкривають двері до радикально нового розуміння та контролю над штучним інтелектом.
- Новий парадигма навчання: Замість безперервного, енергозатратного градієнтного спуску, ми можемо побачити майбутнє, де одна потужна LLM виступає в ролі “архітектора” та “оптимізатора” для багатьох інших моделей.
- Розкриття “чорної скриньки”: “Weight space programming” надає нам інструменти для глибокого розуміння внутрішньої роботи ШІ, що є критично важливим для забезпечення їхньої надійності, безпеки та передбачуваності.
- Рекурсивне самопокращення (RSI): Якщо модель може оптимізувати іншу, вона потенційно може оптимізувати і себе. Це створює можливість для експоненційного зростання можливостей ШІ.
- Майбутнє програмного забезпечення: Можна припустити, що в майбутньому значна частина програмного забезпечення буде існувати у формі таких “зважених” моделей, що дозволить створювати надзвичайно адаптивні та ефективні системи.
Ми знаходимося на порозі нової ери, де машини не лише виконують задачі, а й активно беруть участь у процесі створення, оптимізації та взаємного навчання.
Рекомендації для подальших дій:
- Будьте в курсі подій: Ця галузь розвивається експоненційно. Слідкуйте за новими дослідженнями та публікаціями.
- Експериментуйте: Якщо ви розробник, досліджуйте можливості взаємодії з моделями на більш глибокому рівні. Вивчайте API, які надають доступ до внутрішніх механізмів.
- Стратегічне мислення: Розгляньте, як ці прориви можуть вплинути на вашу галузь, бізнес-процеси та загальний розвиток технологій.
Підсумовуючи, “weight space programming” – це не просто технічне досягнення, а фундаментальний прорив, який обіцяє зробити ШІ більш прозорим, ефективним та потенційно самодостатнім. Це захопливий час для всіх, хто працює або цікавиться сферою штучного інтелекту.