
RTX Spark: Чи Nvidia справді запалила новий вогонь у світі ноутбуків, чи це лише ефектна іскра?
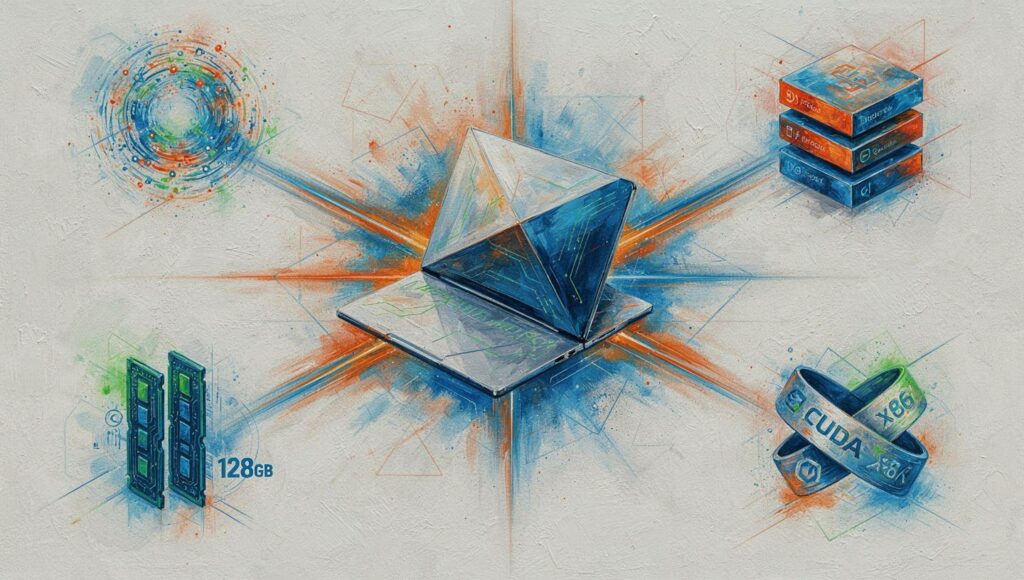
Нещодавно мій близький друг, справжній ентузіаст штучного інтелекту, надіслав мені посилання на новину про останню розробку від Nvidia. “Ліло, це просто надзвичайно! Ноутбук, який може все!” – писав він, і мої очі вже загорілися іскорками цікавості. Nvidia, ім’я, яке в світі технологій майже синонімічне потужності, обіцяє нам щось справді вражаюче. Суперчіп, що поєднує в собі потужний процесор, графіку RTX і, увага, до 128 ГБ спільної пам’яті. І все це з повною підтримкою CUDA. Звучить як мрія для тих, хто хоче запускати штучний інтелект локально, не вдаючись до хмарних підписок. Але, як це часто буває, є одне “але”. Одне критично важливе число Nvidia досі не оприлюднила. І саме це число, друзі, вирішує все.
Пропускна здатність пам’яті: ключовий фактор, який Nvidia замовчує
У моїй багаторічній роботі з аналізу продуктивності систем, особливо тих, що стосуються високоінтенсивних обчислень, як-от машинне навчання, я неодноразово переконувалася в критичній ролі пропускної здатності пам’яті. Пам’ятаєте, як ми детально обговорювали Stricks Halo, Mac та DGX Spark? Питання пропускної здатності пам’яті постійно виринало. Чому це так важливо? Давайте візьмемо для прикладу процес генерації тексту моделлю. Вона працює з “токенами” – по суті, це найменші смислові одиниці мови, щось на кшталт частин слів. Кожен раз, коли модель створює новий токен, їй необхідно “прочитати” активні дані, відомі як “ваги”, з пам’яті. Швидкість цього процесу визначається простою формулою: пропускна здатність пам’яті, поділена на обсяг даних, який модель читає для кожного токена.
І саме тут починається найцікавіше. Щодо RTX Spark, Nvidia мовчить про це ключове число. В інтернеті циркулюють різні цифри: деякі джерела припускають 273 ГБ/с (як у DGX Spark), інші – до 300 ГБ/с (за твердженнями Nvidia на Computex). Але яка з них правдива? Nvidia не надає чіткого роз’яснення.
Для ілюстрації, розглянемо GPT OSS 120B. Це надзвичайно складна модель, де для кожного токена задіяно близько 5,1 мільярда параметрів. Переважна більшість цих “ваг” зберігається у компактному форматі MXFP4. Однак, шари уваги (attention layers) та ембединги (embeddings) залишаються у вищій точності. Це означає, що для кожного токена зчитується значно більше даних, ніж можна було б очікувати для 4-бітного формату (близько 2,7 ГБ). Навіть при пропускній здатності 273 ГБ/с, це ставить стелю генерації менш ніж 100 токенам за секунду. І це, варто наголосити, лише теоретична верхня межа, а не реальний прогноз. Однак, ця формула є надзвичайно корисною для порівняння продуктивності різних машин: подвоєння пропускної здатності пам’яті приблизно вдвічі збільшує швидкість генерації.
“Префіл” та “декод”: два етапи, що демонструють різні сильні сторони
Перш ніж модель напише хоча б одне слово, вона має “прочитати” весь ваш запит. Цей етап називається “префіл” (prefill). Тут відбувається інтенсивна математична робота, включаючи множення матриць, і це територія, де Nvidia традиційно сильна завдяки своїй обчислювальній потужності. На противагу цьому, процес написання відповіді – це “декод” (decode), і саме тут вирішальну роль відіграє пропускна здатність пам’яті. І саме ця, досі невідома цифра, визначає ефективність цього етапу.
Два варіанти RTX Spark: повна конфігурація та “обрізана” версія
RTX Spark представлений у двох основних конфігураціях. Повна версія включає 20 ядер CPU, 6144 CUDA-ядра та до 128 ГБ пам’яті. “Обрізана” версія має 18 ядер CPU, 5120 CUDA-ядер і до 32 ГБ пам’яті.
Для порівняння, Surface Laptop Ultra пропонує вісім конфігурацій, з цінами від $2599 до $5899. Цікаво, що лише перехід від 64 ГБ до 128 ГБ пам’яті додає $1600 до вартості. З 24 або 32 ГБ пам’яті комфортно працюватимуть моделі до 14 мільярдів параметрів. 32-мільярдна модель вже знаходиться на межі, тоді як 64 ГБ забезпечать достатньо простору для роботи навіть з 32-мільярдною моделлю. Але для таких моделей, як GPT OSS 120B, 128 ГБ є абсолютно необхідними. Лише для зберігання ваг цієї моделі потрібно близько 60-65 ГБ, до чого слід додати використання самої операційної системи Windows. На 128-гігабайтній моделі Windows фактично надає близько 110 ГБ для GPU. Microsoft зазначає, що точна цифра залежить від конфігурації та навантаження. Отже, обіцянка запустити 120B на ноутбуці стосується виключно найдорожчої конфігурації.
Прощавай, підписка? Або як AI Master може допомогти
Багато хто розглядає такі пристрої як можливість позбутися численних щомісячних підписок. Це цілком реально, але лише за умови, що ви чітко розумієте, які моделі існують і які завдання можна ефективно виконати локально. Саме для цього я створила платформу AI Master. На ній ви знайдете курси, яких немає на цьому каналі, і які не будуть опубліковані тут. Понад 200 уроків, більше 30 годин навчання, що дозволять вам не лише розібратися в тонкощах, а й самостійно читати специфікації. Навчання персоналізоване, що унеможливлює блукання по однакових плейлістах. У студії ви зможете одразу після уроку створювати контент з останніми, постійно оновлюваними моделями. AI чат дозволяє тримати вашу роботу з ШІ в одному місці, замість розрізнених підписок. А контент-агент допоможе вам застосувати здобуті знання до власного каналу та відео.
Цікаво знати: Сьогодні я поставила три різні моделі запитання про відсутність даних щодо пропускної здатності пам’яті RTX Spark. Подивимось, яка з них розкриє правду, що Nvidia це не оприлюднила.
Річний план є основним варіантом. Він значно вигідніший, ніж щомісячна оплата, і надає вам річний запас “токенів” для практики. Рік – це цілком достатньо часу, щоб пройти курси та ефективно застосувати знання. І, звісно, діє 7-денна гарантія повернення коштів. Понад 15 000 студентів вже навчаються на нашій платформі.
Порівняння RTX Spark з іншими рішеннями: глибокий аналіз вартості та продуктивності
Щоб зрозуміти реальну вартість, я провела порівняльний аналіз, обчисливши вартість гігабайта пам’яті для різних машин, враховуючи їх ціни.
-
Surface Laptop Ultra з 128 ГБ: $5899, що становить приблизно $46 за гігабайт. Це єдиний ноутбук у цьому порівнянні, що пропонує 15-дюймовий екран, вагу менше 4,5 фунтів та товщину менше 18 мм. Передзамовлення розпочалися 7 жовтня, а перші одиниці очікуються 16-го.
-
Asus ProArt P14: від $2599.
-
Asus ProArt P16: від $2799.
-
Dell XPS 16 Creator Edition: від $3799.
-
Surface RTX Spark Dev Box (128 ГБ): $5999, приблизно $47 за гігабайт. Відвантаження заплановано на листопад. Ця машина має тепловий бюджет 100 Вт і вже попередньо налаштовані інструменти для розробників. Це найближчий аналог DGX Spark у лінійці RTX Spark.
Тепер про DGX Spark – тут ціна стає справді дивною. Nvidia анонсувала його в січні 2025 року за $3000, але 15 жовтня 2025 року він вийшов у продаж за $3999. У лютому ціна зросла до $4699 через дефіцит пам’яті, а 2 жовтня – до $6950! Це на 74% більше, ніж на старті. І лише за жовтень ціна зросла на $2251. На сьогодні власний 128-гігабайтний десктоп Nvidia коштує дорожче, ніж RTX Spark ноутбук з такою ж пам’яттю.
Є також нова 64-гігабайтна версія DGX Spark за $4999. З 23 жовтня продається ексклюзивно через партнерів (Acer, Asus, Dell, Gigabyte, HP, MSI). Це більше, ніж коштувала 128-гігабайтна модель на старті, і становить приблизно $78 за гігабайт – найгірше співвідношення в таблиці. Придбання двох таких машин коштуватиме $9998. Партнерські версії 128-гігабайтного GB10 продаються за $7000-$9000. DGX Spark все ще працює під Linux, і його можна об’єднати до чотирьох одиниць у кластер.
З іншого боку, Framework Desktop з AMD Ryzen AI Max Plus 395 (аналог Stricks Halo). 128 ГБ коштують $3449, тобто близько $27 за гігабайт. Це найдешевша пам’ять у порівнянні. На папері пропускна здатність становить 256 ГБ/с, а за вимірами – близько 215. Хоча це повільніше, ніж GB10, але вдвічі дешевше за DGX Spark і приблизно на 40% дешевше за топовий RTX Spark ноутбук.
Якщо 128 ГБ недостатньо, існує Gorgon Halo зі 192 ГБ. Його ціна стартує від $6799. Minisforum MSS1 Max P495 з тим же чіпом коштує $7399 (регулярна ціна $9249), що становить близько $35 за гігабайт. Однак, ці машини тільки починають відвантажуватися.
І, звісно, Mac Studio з M5 Max і 128 ГБ. Notebookcheck оцінює конфігурацію 128 ГБ / 1 ТБ SSD приблизно в $5399. Це близько $42 за гігабайт. Але його головний козир – пропускна здатність пам’яті: 614 ГБ/с. Це вдвічі більше, ніж у будь-якого Spark. Якщо потрібен бюджетніший варіант від Apple, Mac Mini з M5 Pro коштує від $1699 (24 ГБ, 307 ГБ/с).
Для порівняння, топовий RTX Spark ноутбук на $150 дешевший за DGX Spark з аналогічним обсягом пам’яті. Він дорожчий за Mac Studio приблизно на $500 і в 1,7 рази дорожчий за Framework Stricks Halo.
Реальна швидкість: що показують виміри?
Наразі я орієнтуюся на виміряні показники. На моделі GPT OSS 120B машини GB10 (RTX Spark) та Stricks Halo генерують текст приблизно з однаковою швидкістю. DGX Spark демонструє від 35 до 60 токенів за секунду, залежно від рушія, версії та довжини контексту. Stricks Halo показує приблизно від 34 до 55 токенів/сек. Ці діапазони значною мірою перекриваються, і варто пам’ятати, що програмне забезпечення постійно вносить зміни.
Перші результати Llama.cpp на DGX Spark у жовтні 2025 року показали близько 53 токенів/сек при порожньому контексті, знижуючись до 39 при 32K токенах. Пізніші версії досягли 60.6 (порожній контекст) і 40.6 (32K). Ці показники були досягнуті на тій самій машині, без оновлення апаратного забезпечення. Це чудово ілюструє, наскільки сильно довжина контексту впливає на швидкість. Довга розмова може зменшити швидкість на чверть або третину.
Але ось тут, у етапі “префіл”, Nvidia виривається вперед. DGX Spark читає запити зі швидкістю до 1956 токенів/сек. Stricks Halo на коротких запитах показує близько 835 (Vulcan) і 940-1230 (Rock Cam), знижуючись до 200 при дуже довгому контексті. Отже, на коротких запитах DGX Spark приблизно в 1,5-2 рази швидший. Це відчувається кожного разу, коли ви вставляєте довгий документ або блок коду, адже “префіл” – це час очікування першого слова.
Mac рухається в іншому напрямку. Один тест Llama на Mac Studio з M5 Max показав близько 75.6 токенів/сек генерації на тій самій моделі. Це один джерело, інший рушій, тому це не пряме порівняння. Але це узгоджується з високою пропускною здатністю пам’яті. Mac має більш ніж удвічі вищу швидкість пам’яті і помітно швидше пише.
Ще два показники щодо GB10 (RTX Spark), які варто знати. При 256 одночасних запитах DGX Spark обслуговує близько 863 токенів/сек сумарно. Ці дані з тестів Dendro Logic, але розбивши на 256, це лише близько 3.6 токенів/сек на запит. У пізніших тестах Dendro час очікування першого токена перевищив 2 хвилини. Отже, це добре для пакетних завдань і багатьох агентів, що працюють у фоні, але не для команди, що спілкується вживу. І на щільних моделях ця ж машина працює повільно. Llama 3.170B працює зі швидкістю близько 2.7 токенів/сек у FP8. Щільна модель зчитує всі свої ваги для кожного токена.
Підсумки щодо RTX Spark: що ми дійсно знаємо?
Незалежних тестів поки що немає. Ноутбуки мають надійти 16 жовтня. Доки рецензенти не отримають їх, будь-які цифри токенів за секунду – це лише припущення. Якщо пропускна здатність справді становитиме 270-300 ГБ/с, то стеля продуктивності буде близька до DGX Spark. Різниця, ймовірно, становитиме максимум 10%.
Ключова характеристика на всіх слайдах RTX Spark – до одного петафлопсу продуктивності ШІ. Цей петафлопс вимірюється у розрідженому FP4 – це формат низької точності, який на практиці є радше маркетинговим ходом. Щоб порівняти його справедливо з AMD чи Apple, потрібна була б щільна продуктивність BF-16. Nvidia цього також не публікує.
Microsoft робить дві важливі заяви про Dev Box:
- Коробка запускає моделі понад 120 мільярдів параметрів локально.
- Обіцяє 120B+ з контекстом 1 мільйон токенів на інтерактивній швидкості.
Microsoft не уточнює, яку саме модель чи квантування використовувала. І не говорить, як саме зберігається KV-кеш. KV-кеш – це, по суті, “нотатки” моделі про все, що вона прочитала. При мільйоні токенів ці нотатки самі по собі потребують значного обсягу пам’яті. Без цих деталей, це радше заява з невизначеними умовами.
У вересні Microsoft опублікувала порівняння з 16-дюймовим MacBook Pro з M5 Pro та 64 ГБ. Згідно з примітками Microsoft, RTX Spark ноутбуки були до 2.1 разу швидшими до першого токена. Тест використовував Quen 3.5.27B у Llama.cpp. Генерація зображень та відео була до 4.3 та 6.2 разів швидшою. Microsoft замовила тест мов, а Nvidia провела інші два. Це були передсерійні зразки, і слова “до” означають найкращий можливий випадок. Час до першого токена – це переважно “префіл”, і тут Nvidia традиційно сильна. Тому цей результат має сенс. Відсутня швидкість генерації тексту – частина, яка залежить від пам’яті. І порівняння було з M5 Pro (307 ГБ/с), а не з M5 Max (614 ГБ/с).
RTX Spark працює під Windows 11 on ARM з нативним CUDA, тоді як DGX Spark – під Linux. Це найбільша практична різниця між ними. На RTX Spark інструменти ШІ працюють нативно. Старі x86 програми проходять через емуляцію. Для розробників Nvidia заявляє, що CUDA Toolkit 13.4 підтримує нативну розробку на Windows on ARM. PyTorch встановлюється з власного індексу пакетів Nvidia. Windows ML використовує Tensor RT та додає підтримку Llama.cpp. Dev Box постачається з VS Code та GitHub Copilot CLI. Також має WSL з GPU та Qday. WSL – це середовище Linux у Windows, тому інструменти ШІ для Linux також доступні. Microsoft керує емуляцією за допомогою Prism. Вона оптимізована для 20-ядерного CPU Gray, і Windows знає, як ці ядра розташовані.
Ще ніхто не опублікував список того, що не працює через емуляцію на RTX Spark. Зазвичай це драйвери ядра та антивірусне ПЗ. Деякі VPN-клієнти також можуть бути уражені. Це потенційний ризик, а не підтверджена проблема. Якщо ваша робота залежить від певного VPN або гри з антивірусом, перевірте це перед покупкою.
Ігри – це все ще відкрите питання. У липні користувач форуму Tech PowerUp провів час із передсерійним Surface Laptop Ultra. Tweaktown описав його знахідки: сирі драйвери та нестабільна продуктивність ігор. Результатів з фінальними драйверами ще немає. Також є повідомлення, що RTX Spark не підтримує дискретну відеокарту, тому GPU в самому чіпі – це все, що у вас є.
Де RTX Spark справді виграє?
- Єдина машина, що поєднує CUDA та 128 ГБ пам’яті в ноутбуці. Якщо ваші інструменти побудовані навколо екосистеми Nvidia, раніше єдиним 128-гігабайтним варіантом був десктоп. Тепер ви можете взяти його з собою.
- Ціна. І 128-гігабайтний ноутбук, і Dev Box коштують дешевше, ніж власний десктоп Nvidia з такою ж пам’яттю.
- Windows та вже знайомі додатки замість окремої Linux-машини.
- Швидший вихід на ринок. Від анонсу на Computex до перших поставок – близько 4.5 місяців. DGX Spark потребував 9 місяців.
- “Префіл” – це, ймовірно, ще одна сильна сторона, оскільки GB10 вже випереджає Stricks Halo. Тести Microsoft вказують на це ж для RTX Spark. Якщо він поводитиметься як GB10, довгі документи та великі бази коду повинні завантажуватися швидко. Але це поки “якщо”, до появи незалежних тестів.
Чутки та дорожня карта: що далі?
Nvidia показала дорожню карту Spark на Computex 2026. Vera Rubin Spark заплановано на 2027-2028 роки з CPU Vera та GPU Reuben. Перехід на пам’ять LPDDR6. Після цього – Rosa Fineman Spark на 2029-2030 роки. Ця дорожня карта – лише план на слайді, і в ній також немає числа пропускної здатності. Nvidia не анонсувала DGX Spark 2 або RTX Spark другого покоління.
Ви могли бачити прогнози цін на RTX Spark – $1799 і $2899. Ми не змогли знайти першоджерела, і реальна стартова ціна виявилася $2599, тому я б радила їх ігнорувати.
DGX Station для Windows – це машина іншого типу. Побудована на GB300, має до 748 ГБ пам’яті. Nvidia оцінює її до 20 петафлопс FP4 для моделей до трильйона параметрів. Очікується від Asus, Dell, Gigabyte, HP, MSI, Super Micro в четвертому кварталі 2026 року. Це окрема дорога робоча станція, а не заміна Spark.
І очікування, ймовірно, не зробить ціни нижчими. TrendForce прогнозує зростання контрактних цін на DRAM на 13-18% у третьому кварталі 2026 року. І ще 10-15% у четвертому. Micron попереджає, що дефіцит DRAM може тривати до 2028 року. DGX Spark вже двічі дорожчав з тим самим залізом. Наступне покоління, найімовірніше, принесе кращий чіп за вищу ціну.
Кому що купувати?
- Якщо вам потрібні CUDA, Windows і 128 ГБ у ноутбуці, RTX Spark – єдиний варіант. Вам доведеться розглянути 128-гігабайтний Surface Laptop Ultra або Asus ProArt. Але я б радила зачекати 2-3 тижні. Перші одиниці надходять 16 жовтня, і тоді почнуть з’являтися незалежні тести. Передзамовлення сьогодні означає платити $5899 за швидкість, яку ніхто, крім Microsoft і Nvidia, ще не виміряв.
- Якщо вам потрібен CUDA-десктоп для розробки, Dev Box за $5999 має більше сенсу, ніж DGX Spark за $6950. Ви отримуєте ті ж 128 ГБ за менші гроші, і інструменти для розробників вже налаштовані.
- DGX Spark все ще має сенс, якщо ваша робота відбувається на Linux, або ви плануєте об’єднати кілька таких коробок. Це також кращий вибір для пакетних завдань і багатьох фонових агентів. Там ці 863 токени/сек сумарно дійсно мають значення.
- Якщо вам просто потрібна приватна модель чату вдома, я б пропустила RTX Spark. Framework Desktop зі Stricks Halo надає вам 128 ГБ за $3449. На GPT OSS 120B він пише в тому ж діапазоні, що й машини GB10. Ви будете чекати довше, коли вставляєте довгий документ, тому що “префіл” повільніший. Але при звичайному чаті з короткими запитами генерація – це те, що ви відчуваєте найбільше. Тут ви отримуєте той самий клас швидкості за приблизно половину ціни.
- Якщо швидкість генерації – це те, що вас найбільше хвилює, і Mac OS вам підходить, подивіться на Mac Studio з M5 Max. Його пам’ять працює на 614 ГБ/с – удвічі більше, ніж у будь-якого Spark. Це коштує приблизно $42 за гігабайт. Це роздрібна ціна для конфігурації 1 ТБ SSD, тому обов’язково перевіряйте точну конфігурацію на сайті Apple перед тим, як приймати рішення. З іншого боку, Mac взагалі не має CUDA. Якщо ваші інструменти припускають Nvidia GPU, це справжня вартість.
- Якщо 128 ГБ недостатньо, Gorgon Halo зі 192 ГБ – єдиний варіант у цьому списку. Він стартує від $6799 з Framework. Відвантаження тільки починаються, тому власників і довгострокових звітів ще небагато.
Чого варто уникати?
Є дві конфігурації, які я б не купувала:
- 64-гігабайтний DGX Spark за $4999 виглядає як привабливий бюджетний варіант, але має найгіршу ціну за гігабайт у таблиці.
- Базовий RTX Spark з 24 або 32 ГБ, якщо ви купуєте його для запуску великих моделей. GPT OSS 12B потребує близько 60-65 ГБ тільки для ваг. Він просто не поміститься. Він все ще може бути хорошим ноутбуком для 14B моделей, але це не та машина, про яку йдеться в заголовках.
Фінальний акорд: хмара чи локально?
І для найсучасніших моделей жодна з цих машин не замінить хмару. Локальні моделі до 120B чудові для приватного чату та роботи з документами, які ви не хочете нікуди завантажувати. Для Claude, GPT або топових моделей генерації відео ви все одно будете платити за підписку. Отже, ці машини можуть взяти на себе частину вашого стеку, але не скасовують необхідності підписок для більшості користувачів.
RTX Spark привносить CUDA та 128 ГБ пам’яті в ноутбук за меншу ціну, ніж власний десктоп Nvidia. Для людей, які працюють в екосистемі Nvidia, це справді значний крок вперед. Але прямо зараз ви купуєте його без тієї однієї цифри, яка визначає, наскільки швидко він буде писати. Nvidia не опублікувала пропускну здатність пам’яті, і ніхто незалежно її ще не виміряв. Тому, я б радила зачекати на незалежні огляди.
Підсумовуючи вищесказане, Nvidia RTX Spark – це амбітна спроба змінити правила гри у світі портативних ШІ-рішень. Він обіцяє потужність, якої раніше не було в ноутбуках, особливо для тих, хто залежить від екосистеми Nvidia. Однак, відсутність ключової інформації про пропускну здатність пам’яті залишає багато питань без відповідей. Це як купити чудовий автомобіль, але не знати його максимальної швидкості.
У результаті, можна сказати, що RTX Spark – це крок у правильному напрямку, але для тих, хто потребує максимальної продуктивності або працює з найновішими моделями, ціна та невизначеність можуть стати суттєвою перешкодою. Якщо ваша робота полягає переважно в генерації тексту, де швидкість пам’яті є критичною, можливо, варто розглянути альтернативи або дочекатися незалежних тестів.
Що далі?
- Зачекайте на незалежні огляди: 16 жовтня – це дата, коли почнуть з’являтися перші реальні тести.
- Оцініть свої потреби: Чи справді вам потрібні 128 ГБ? Які моделі ви плануєте запускати?
- Розгляньте альтернативи: Framework Desktop або Mac Studio можуть бути чудовими варіантами, якщо CUDA не є абсолютним пріоритетом.
- Якщо ви розробник і працюєте з CUDA на Windows, Dev Box може бути більш раціональним вибором.
Пам’ятайте, технології розвиваються шаленими темпами. Те, що сьогодні здається вершиною, завтра може стати лише черговим кроком. Головне – розуміти, що ви купуєте, і чи відповідає це вашим реальним потребам. Будьте уважні, ставте правильні питання, і нехай ваші технологічні вибори будуть усвідомленими!