
Поглиблене Занурення у Моделі ComfyUI: Як ШІ Перетворює Цифровий Шум на Шедеври
Як старший редактор із понад 20-річним досвідом у бізнес-аналізі, автоматизації та штучному інтелекті, я бачив чимало трансформацій у технологічному світі. Проте, саме в царині генеративного ШІ, особливо в таких платформах, як ComfyUI, я знаходжу неперевершений потенціал для творчості. Те, що спочатку може здатися абстрактним “кодом” чи “алгоритмами”, насправді є магією перетворення хаотичних даних на чіткі, осмислені результати. Сьогодні ми глибоко зануримося у серце цих процесів – моделі ComfyUI.
Багато хто, чуючи терміни “моделі”, “AI” чи “ComfyUI”, відчуває певну відстороненість. Я усвідомлюю це. Хоча мій досвід вимірюється десятиліттями, я завжди намагаюся пояснювати складні концепції максимально доступно, без зайвого технічного жаргону, який може відштовхнути. Уявіть, що ми разом, за чашкою кави, досліджуємо цю захопливу сферу. Моя мета – не просто надати інформацію, а поділитися практичними інсайтами, здобутими з власного досвіду роботи з цими інструментами.
ComfyUI – це, по суті, ваша цифрова майстерня. Моделі ж у ній – це найцінніші інструменти, унікальні матеріали, без яких ця майстерня залишається лише порожнім простором. Без них, навіть найскладніші робочі процеси (workflows) є лише сукупністю елементів, позбавлених функціональності. Навіть якщо ви вже маєте певне розуміння, я обіцяю, що сьогодні ви дізнаєтеся щось нове, що поглибить ваше сприйняття.
Перший Акт: Розуміння Суті Моделей та Їхньої Незамінності
Уявімо, що ваше завдання – створити зображення. Скажімо, “щасливий золотистий ретривер, що грається на пляжі під час заходу сонця”. Для нас, людей, це чітке візуальне уявлення. Однак, для комп’ютера, ці слова – лише послідовність символів. Він не інтерпретує “щастя” чи “красу заходу сонця” так, як ми.
Саме тут на сцену виходять моделі. Це, по суті, “навчені” системи, які слугують “мозком” для ШІ, дозволяючи йому інтерпретувати та генерувати дані, які ми хочемо бачити. У ComfyUI, моделі є фундаментом. Без них вузли (nodes) в робочому процесі – це лише статичні схеми, позбавлені будь-якої здатності до дії.
Я б порівняв моделі з командою вузькоспеціалізованих професіоналів: архітектор, художник-портретист, майстер пейзажів. Кожен має свої унікальні навички. ComfyUI ж виступає в ролі диригента, який керує цією командою, щоб створити цілісний витвір.
Другий Акт: Дифузійні Моделі – Серце Генеративного Процесу
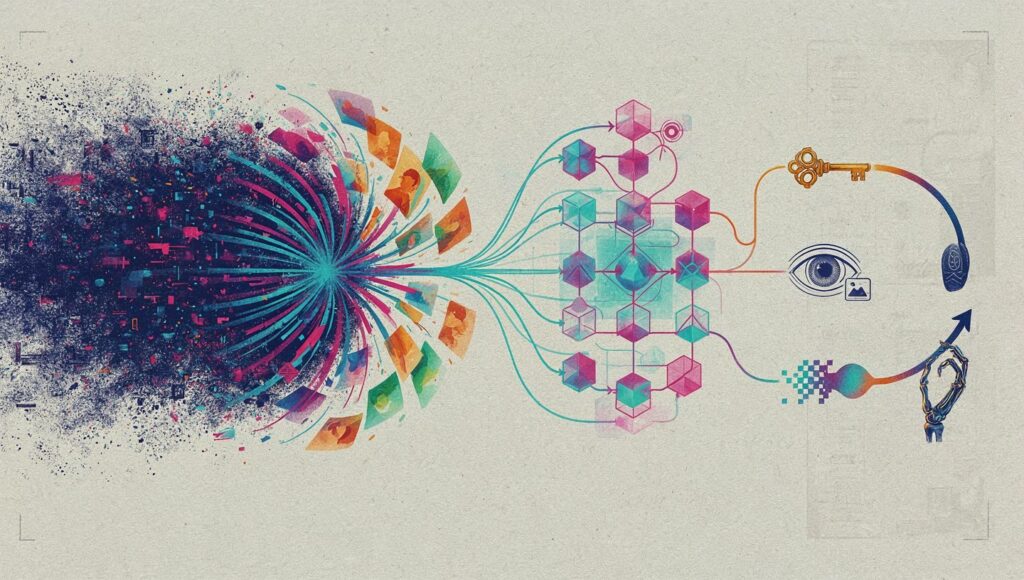
У контексті генерації зображень та відео, дифузійні моделі (Diffusion Models) є, без перебільшення, серцем технології. Саме вони відповідають за “магію” перетворення випадкового шуму на осмислене зображення, яке відповідає вашому текстовому запиту (prompt).
Кожен, хто працює з ComfyUI, розуміє, що, по суті, будь-який складний робочий процес обертається навколо однієї або кількох таких моделей.
Їхня значна вага – від 6 ГБ для старих версій до 10-20 ГБ, а інколи й до 40 ГБ для сучасних – має прямий вплив на продуктивність з двох ключових причин:
- Дисковий простір: Зберігання колекції таких моделей вимагає значного обсягу пам’яті на жорсткому диску. Це схоже на колекціонування великих музичних альбомів, кожен з яких займає значне місце.
- Оперативна пам’ять відеокарти (VRAM): Під час роботи, дифузійна модель повністю завантажується у VRAM вашої відеокарти. Якщо її обсяг недостатній, система змушена використовувати загальну оперативну пам’ять комп’ютера, що різко знижує швидкість обробки.
Мій досвід підкреслює: VRAM вашої відеокарти – це один із найбільш критичних факторів для комфортної роботи з ComfyUI. Якщо модель не вміщується у VRAM, процес або займатиме непомірно багато часу, або взагалі не запуститься. Тому, при виборі обладнання для роботи з ШІ, обсяг VRAM повинен бути пріоритетом.
Третій Акт: LoRA – Ефективні Модифікатори Основних Моделей
Поряд з основними дифузійними моделями, ви неодмінно стикатиметеся з LoRA (Low-Rank Adaptation). Незважаючи на складну назву, їхня функція доволі проста: вони слугують модифікаторами, що тонко налаштовують поведінку основної дифузійної моделі. Самі по собі LoRA не генерують зображення, але вони скеровують дифузійну модель до досягнення специфічних результатів.
Наведемо приклад з практики: припустимо, ви хочете згенерувати портрет конкретної людини. Якщо ця людина не є загальновідомою, велика дифузійна модель, ймовірно, не матиме її у своїх навчальних даних. Однак, ви можете навчити LoRA на кількох фотографіях цієї людини. Така LoRA запам’ятає унікальні риси обличчя. Поєднавши цю LoRA з дифузійною моделлю в ComfyUI, ви отримаєте можливість генерувати реалістичні портрети цієї людини з вражаючою точністю, в різних ракурсах та освітленні.
Цей принцип стосується не лише облич: LoRA можуть бути навчені на:
- Конкретні художні стилі
- Дизайн продуктів
- Персонажі з фільмів чи ігор
- Особливі типи одягу
- Архітектурні стилі
LoRA – це один з найпотужніших інструментів для кастомізації генеративного ШІ. Їхній невеликий розмір дозволяє створювати та зберігати великі колекції, легко перемикаючись між ними. Це надає гнучкість, подібну до можливості мати безліч аксесуарів для одягу, кожен з яких додає унікальну “родзинку”.
Четвертий Акт: CLIP – Інтерпретатори Між Людською Мовою та Математикою
Крім дифузійних моделей та LoRA, існують ще три типи моделей, які відіграють важливу, хоч і менш видиму роль. Розуміння їхньої роботи допоможе вам краще діагностувати проблеми та оптимізувати робочі процеси.
Першою є CLIP модель (Contrastive Language-Image Pre-training). Коли ви вводите текстовий запит, наприклад, “золотистий ретривер сидить на пляжі під час заходу сонця”, для нас це зрозуміло. Але дифузійна модель працює в математичному просторі, відомому як латентний простір (latent space). CLIP модель виступає як перекладач, трансформуючи ваш текстовий запит у числовий формат, з яким дифузійна модель може працювати. Цей переклад і стає “кондиціонуванням” (conditioning), що керує процесом генерації.
В моєму досвіді, якість перекладу CLIP моделі має колосальне значення. Вона визначає, наскільки точно ШІ зрозуміє нюанси вашого запиту. Слабкий CLIP може призвести до того, що модель пропустить ключові елементи опису або неправильно їх інтерпретує.
Важливо пам’ятати: Різні дифузійні моделі розроблені для роботи з конкретними CLIP моделями. Це пов’язано з тим, що дифузійна модель тренувалася, очікуючи вхідні дані у певному форматі, який генерує її “рідна” CLIP. Використання несумісної CLIP моделі – це як найняти перекладача, який говорить не ту мову. Результатом може бути помилка або, що гірше, правильний формат, але втрачений зміст. Завжди перевіряйте документацію моделі, щоб дізнатися, яку CLIP модель використовувати.
П’ятий Акт: VAE – Міст Між Латентним Світом та Реальністю
Другий ключовий компонент – VAE (Variational Autoencoder). Щоб зрозуміти його роль, треба усвідомити, що дифузійна модель не працює безпосередньо з пікселями зображення, як ми їх бачимо. Вона оперує у стиснутому, абстрактному латентному просторі.
VAE виконує функцію порталу:
- Кодування: Коли ви використовуєте функціонал “зображення до зображення” (image-to-image), VAE бере ваше видиме зображення і “стискає” його в латентний простір, роблячи його придатним для обробки дифузійною моделлю.
- Декодування: Після того, як дифузійна модель завершила генерацію у латентному просторі, VAE бере ці дані і “розгортає” їх назад у повноцінне, видиме RGB-зображення.
Особистий висновок: Я неодноразово стикався з тим, що неправильно підібраний VAE призводить до спотворення кольорів або втрати дрібних деталей, таких як текст. Тому, як і у випадку з CLIP, VAE має бути сумісним з дифузійною моделлю. Часто нові VAE пропонують кращу деталізацію та точність передачі кольорів.
Шостий Акт: ControlNet – Режисер Композиції Зображення
Якщо дифузійна модель та текстовий запит визначають що буде згенеровано, то ControlNet визначає як це буде структуровано.
Припустимо, ви задаєте запит “жінка стоїть у саду”. Дифузійна модель створить зображення, але композиція (поза, кут зйомки, розташування елементів) буде результатом її “вибору”. ControlNet ж надає вам контроль над цими структурними аспектами.
Як це працює:
- Ви надаєте референсне зображення (наприклад, фото людини).
- Препроцесор ControlNet аналізує це зображення і витягує структурну інформацію: карту пози (pose map), карту глибини (depth map), контури (Canny edges) тощо.
- Ця структурна інформація передається в ControlNet модель, яка, у свою чергу, скеровує дифузійну модель під час генерації.
Результатом буде зображення, яке відповідає вашому текстовому запиту, але зберігає структурні особливості референсного зображення. Наприклад, ідентичну позу, але іншу людину, одяг чи фон.
ControlNet підтримує різноманітні типи структурного контролю:
- Карти глибини (Depth maps): Відтворюють відчуття тривимірного простору, фіксуючи, що знаходиться ближче, а що далі.
- Карти країв (Edge maps / Canny): Зберігають контури та обриси, дозволяючи відтворити силуети або складні деталі.
- Лінійне мистецтво (Line art): Дозволяє ШІ перетворити ваш ескіз на детальне зображення, дотримуючись заданих ліній.
З мого досвіду, ControlNet є одним з найбільш цінних інструментів для досягнення точних та повторюваних результатів у ComfyUI.
Сьомий Акт: Еволюція Моделей – Постійний Рух Вперед
Сфера генеративного ШІ розвивається надзвичайно швидко. Замість того, щоб фокусуватися на застарілій інформації, важливо розуміти загальні тенденції.
- Stable Diffusion 1.5 (2023): Була значним проривом, що популяризувала генерацію зображень. Її спільнота створила величезну кількість похідних моделей та LoRA. Хоча якість сьогодні може здаватися обмеженою (особливо з руками та обличчями), це був важливий крок, що надав користувачам безпрецедентний контроль у порівнянні з іншими платформами.
- SD XL (Stable Diffusion XL): Значно покращила якість та можливості, ставши де-факто стандартом у 2024 році.
- Сучасні моделі: Сьогодні ми бачимо появу нових архітектур, таких як Waifu, Quan, Flock, Z Image, а також закритих моделей, як-от Gemini та Nano Banana. Кожна з них має свої переваги щодо швидкості, якості або специфічних функцій.
Головне, що я засвоїв: Не важливо, яка модель є “найкращою” сьогодні, адже завтра вона може бути замінена. Важливо розуміти принципи роботи моделей у ComfyUI, щоб ви могли швидко адаптуватися до нових технологій, які з’являються майже щотижня.
Фінальний Акт: Ваші Наступні Кроки до Майстерності
Ми пройшли шлях від розуміння фундаментальних концепцій до практичних інструментів, які дозволяють керувати генеративним ШІ. Моделі – це основа ComfyUI. Глибоке розуміння їхньої ролі та взаємодії – це ключ до розкриття повного потенціалу платформи.
Висновок: Моделі є серцем будь-якого AI-творіння в ComfyUI. Розуміння їхньої взаємодії – це шлях до майстерності. Не бійтеся експериментувати, завантажувати нові моделі та пробувати різні комбінації.
Рекомендовані наступні кроки:
- Дослідження: Відвідайте ресурси на кшталт Hugging Face та Civitai. Ознайомтеся з доступними моделями, читайте описи та вивчайте приклади.
- Практика: Завантажте кілька дифузійних моделей, LoRA, VAE та CLIP. Спробуйте інтегрувати їх у прості робочі процеси ComfyUI. Це найкращий спосіб навчитися.
- Увага до документації: Завжди перевіряйте, яку CLIP та VAE модель рекомендують для конкретної дифузійної моделі. Це зекономить вам багато часу та нервів.
- Залучення до спільноти: Discord-сервери, форуми – це місця, де ви можете отримати допомогу та поділитися досвідом з іншими користувачами.
Пам’ятайте, майбутнє ШІ твориться зараз, і ви можете бути його активним учасником. Нехай ваші творчі задуми знаходять найсміливіші форми за допомогою цих потужних інструментів.
Дякую, що провели цей час зі мною. До нових технічних відкриттів!